
Databricks-Certified-Data-Engineer-Professional 試験問題 16
Incorporating unit tests into a PySpark application requires upfront attention to the design of your jobs, or a potentially significant refactoring of existing code.
Which statement describes a main benefit that offset this additional effort?
Which statement describes a main benefit that offset this additional effort?
Databricks-Certified-Data-Engineer-Professional 試験問題 17
データエンジニアリングチームは、以下のコードを保守管理しています。
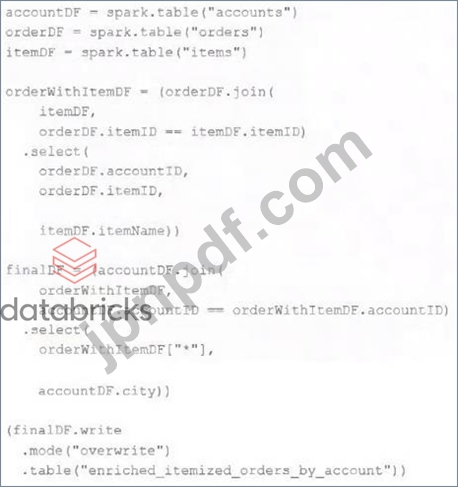
このコードが論理的に正しい結果を生成し、ソーステーブルのデータが重複排除および検証済みであると仮定した場合、このコードが実行されたときに何が起こるかを説明しているのはどの記述ですか?
このコードが論理的に正しい結果を生成し、ソーステーブルのデータが重複排除および検証済みであると仮定した場合、このコードが実行されたときに何が起こるかを説明しているのはどの記述ですか?
Databricks-Certified-Data-Engineer-Professional 試験問題 18
データエンジニアが、サードパーティが提供するREST APIエンドポイントから、異なるレポートタイプを指定して複数のPDFファイルをダウンロードするジョブを実装しています。このREST APIは処理に時間がかかり、断続的にエラーが発生するため、エンジニアは各ダウンロードアクティビティを追跡し、失敗したタイミングを把握して部分的に再試行するとともに、スケーラブルなスループットを実現したいと考えています。エンジニアは10種類のレポートタイプをダウンロードする必要があり、そのリストは時間とともに変更される可能性があります。データエンジニアはどのようにしてこれを実現すべきでしょうか?
Databricks-Certified-Data-Engineer-Professional 試験問題 19
データエンジニアは、スキーマ finance の Unity Catalog テーブル customer_data を管理しています。このテーブルには、ssn や credit_score などの機密フィールドが含まれています。インターン生グループはマスクされた値のみを表示でき、アナリストグループは割り当てられた地域の行のみにアクセスできる必要があります。データエンジニアは、データの重複を避けつつ、ユーザーの役割と地域に基づいてアクセスを制限する必要があります。データエンジニアは、このセキュリティポリシーをどのように適用すべきでしょうか?
Databricks-Certified-Data-Engineer-Professional 試験問題 20
データエンジニアは、非常に類似したコードを含む複数のテーブル定義を含む以下のDLTコードをリファクタリングしたいと考えています。
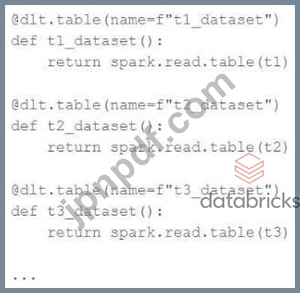
パラメータ化されたテーブル定義を使用してこれらのテーブルをプログラムで作成しようとして、データエンジニアは次のコードを作成しました。

パイプラインはこのリファクタリングされたコードを使用して更新を実行しますが、これらのテーブルに対して誤った構成値を示す異なるDAGを生成します。
データエンジニアはこれをどのように修正すればよいでしょうか?
パラメータ化されたテーブル定義を使用してこれらのテーブルをプログラムで作成しようとして、データエンジニアは次のコードを作成しました。
パイプラインはこのリファクタリングされたコードを使用して更新を実行しますが、これらのテーブルに対して誤った構成値を示す異なるDAGを生成します。
データエンジニアはこれをどのように修正すればよいでしょうか?