
Databricks-Certified-Data-Engineer-Professional 試験問題 1
データエンジニアは、非常に類似したコードを含む複数のテーブル定義を含む以下のDLTコードをリファクタリングしたいと考えています。
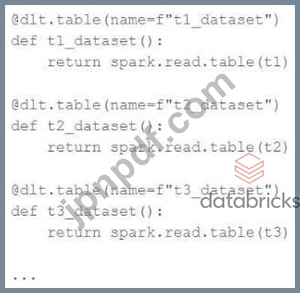
パラメータ化されたテーブル定義を使用してこれらのテーブルをプログラムで作成しようとして、データエンジニアは次のコードを作成しました。

パイプラインはこのリファクタリングされたコードを使用して更新を実行しますが、これらのテーブルに対して誤った構成値を示す異なるDAGを生成します。
データエンジニアはこれをどのように修正すればよいでしょうか?
パラメータ化されたテーブル定義を使用してこれらのテーブルをプログラムで作成しようとして、データエンジニアは次のコードを作成しました。
パイプラインはこのリファクタリングされたコードを使用して更新を実行しますが、これらのテーブルに対して誤った構成値を示す異なるDAGを生成します。
データエンジニアはこれをどのように修正すればよいでしょうか?
Databricks-Certified-Data-Engineer-Professional 試験問題 2
Databricksを使い始めたばかりのユーザーが、作業中のパイプラインロジックの実行時間が長いという問題のトラブルシューティングを行っています。現在、ユーザーはコードをセルごとに実行し、display() 関数を使用して、操作に新しい変換が追加されるたびにコードが論理的に正しい結果を生成していることを確認しています。平均実行時間を測定するため、ユーザーは各セルを対話的に複数回実行しています。
以下の調整のうち、本番環境でコードがどの程度のパフォーマンスを発揮するかをより正確に測定できるのはどれですか?
以下の調整のうち、本番環境でコードがどの程度のパフォーマンスを発揮するかをより正確に測定できるのはどれですか?
Databricks-Certified-Data-Engineer-Professional 試験問題 3
データエンジニアは、Unityカタログで管理されているテーブルの機密性の高い列に対して、列マスキングを実装する必要があります。マスキングロジックでは、ユーザーが別のテーブル(group_access)で定義された特定のグループに属しているかどうかを動的にチェックする必要があります。このテーブルでは、グループが許可された部署にマッピングされています。エンジニアは、この要件を効率的に満たすために、どの方法を用いるべきでしょうか?
Databricks-Certified-Data-Engineer-Professional 試験問題 4
データエンジニアリングチームは、以下のコードを保守管理しています。
最新かつ実際の認定データエンジニアプロフェッショナル試験の質問と回答を入手するには、
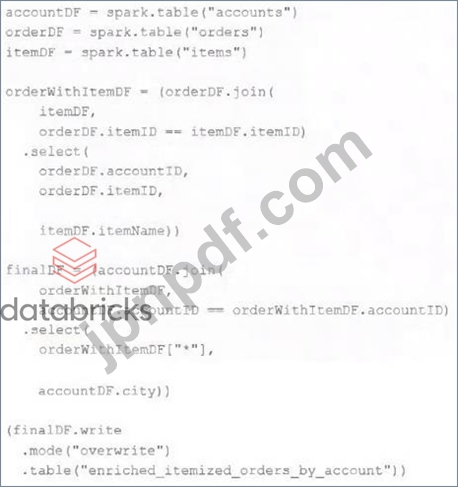
このコードが論理的に正しい結果を生成し、ソーステーブルのデータが重複排除および検証済みであると仮定した場合、このコードが実行されたときに何が起こるかを説明しているのはどの記述ですか?
最新かつ実際の認定データエンジニアプロフェッショナル試験の質問と回答を入手するには、
このコードが論理的に正しい結果を生成し、ソーステーブルのデータが重複排除および検証済みであると仮定した場合、このコードが実行されたときに何が起こるかを説明しているのはどの記述ですか?
Databricks-Certified-Data-Engineer-Professional 試験問題 5
新任のデータエンジニアが、KafkaソースをDelta Lakeに書き込むアプリケーションから重要なフィールドが欠落していることに気づきました。重要なフィールドはKafkaソースには存在していたにもかかわらず、このような事態が発生しました。
さらに、そのフィールドは、依存型の長期保存ストレージに書き込まれたデータにも含まれていませんでした。Kafkaサービスの保持期間は7日間です。パイプラインは3か月間運用されています。
Delta Lakeが将来的にこのようなデータ損失を回避するのにどのように役立つかを説明しているのはどれですか?
さらに、そのフィールドは、依存型の長期保存ストレージに書き込まれたデータにも含まれていませんでした。Kafkaサービスの保持期間は7日間です。パイプラインは3か月間運用されています。
Delta Lakeが将来的にこのようなデータ損失を回避するのにどのように役立つかを説明しているのはどれですか?