
Databricks-Certified-Data-Engineer-Professional 試験問題 46
データサイエンスチームは、MLflowを使用して本番モデルを作成し、ログに記録しました。以下のコードは、本番モデルを正しくインポートして適用し、予測結果を「customer_id LONG、predictions DOUBLE、date DATE」というスキーマを持つpredsという名前の新しいDataFrameとして出力します。

データサイエンスチームは、予測結果をDelta Lakeテーブルに保存し、時系列で全ての予測結果を比較できる機能を求めています。顧客離脱予測は、1日に最大1回行われます。
計算コストを最小限に抑えつつ、このタスクを実行するコードブロックはどれですか?
データサイエンスチームは、予測結果をDelta Lakeテーブルに保存し、時系列で全ての予測結果を比較できる機能を求めています。顧客離脱予測は、1日に最大1回行われます。
計算コストを最小限に抑えつつ、このタスクを実行するコードブロックはどれですか?
Databricks-Certified-Data-Engineer-Professional 試験問題 47
データエンジニアが対話型ノートブックで作業しており、display(df.collect()) から結果を出力する前に、多くの変換処理を行っています。このノートブックには、広範囲な変換処理とクロス結合が含まれています。
データエンジニアは、「Sparkドライバが予期せず停止し、再起動しています。ノートブックは自動的に再接続されます。」というエラーを受け取っています。データエンジニアはどのような対応を取るべきでしょうか?
データエンジニアは、「Sparkドライバが予期せず停止し、再起動しています。ノートブックは自動的に再接続されます。」というエラーを受け取っています。データエンジニアはどのような対応を取るべきでしょうか?
Databricks-Certified-Data-Engineer-Professional 試験問題 48
ビューは以下のコードで登録されます。

ユーザーと注文はどちらもデルタレイクのテーブルです。
recent_orders をクエリした結果を説明しているのは、次のうちどれですか?
ユーザーと注文はどちらもデルタレイクのテーブルです。
recent_orders をクエリした結果を説明しているのは、次のうちどれですか?
Databricks-Certified-Data-Engineer-Professional 試験問題 49
上流ソースは、Parquetデータを1時間ごとのバッチとして、現在の日付で命名されたディレクトリに書き込みます。夜間バッチジョブは、日付変数で示される前日のすべてのデータを取り込むために、次のコードを実行します。
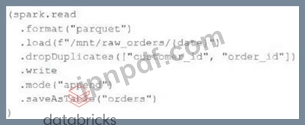
customer_idとorder_idというフィールドは、各注文を一意に識別するための複合キーとして機能すると仮定します。
上流システムが、単一の注文に対して数時間間隔で重複したエントリを生成することが時折発生することがわかっている場合、次の記述のうちどれが正しいですか?
customer_idとorder_idというフィールドは、各注文を一意に識別するための複合キーとして機能すると仮定します。
上流システムが、単一の注文に対して数時間間隔で重複したエントリを生成することが時折発生することがわかっている場合、次の記述のうちどれが正しいですか?
Databricks-Certified-Data-Engineer-Professional 試験問題 50
データエンジニアは、チームメイトが作成した新しいSparkアプリケーションを本番環境に導入する必要があります。このアプリケーションは、ライブラリを含む多数の外部依存関係を持ち、カスタム環境変数とSpark構成パラメータを設定する必要があります。データエンジニアがこのタスクを達成するのに役立つ2つの方法はどれですか?(2つ選択してください。)